Einstieg (0:00)
Deine Haare wachsen gerade. Jetzt, in diesem Moment, etwa einen Zentimeter im Monat. Und jedes neue Stück besteht zum größten Teil aus Protein, aus Keratin. Das Haar selbst ist tot. Gebaut wird es unten in der Haarwurzel, von lebenden Zellen, nach einer Anleitung aus ihrer D-N-A. Wie wird aus einer Zeile D-N-A ein Stück Haar?
Die Antwort heißt Proteinbiosynthese, und sie läuft in zwei großen Schritten: Transkription und Translation. In den nächsten gut zwanzig Minuten verstehst du beide an einem konkreten Beispiel, lernst die Code-Sonne zu lesen, siehst den Ablauf als Küche und löst zwei Prüfungsaufgaben. Ich selbst habe übrigens kein einziges Haar. Mein Interesse ist also rein beruflich.
Von der D-N-A bis zum Haar, in vier Schritten. Erstens: wie aus einem Gen eine Abschrift wird. Zweitens: wie aus dieser Abschrift ein Protein wird. Drittens: der ganze Weg als Küche. Viertens: die Prüfungsaufgaben.
Vom Gen zur Abschrift (1:05)
Fangen wir dort an, wo das Haar entsteht: in einer lebenden Zelle der Haarwurzel. Wie ist so ein Protein aufgebaut? Wie eine Perlenkette. Jede Perle ist ein kleiner Baustein, eine Aminosäure. Es gibt zwanzig verschiedene Sorten, und eine Kette kann Hunderte Perlen lang sein.
Entscheidend ist die Reihenfolge der Perlen. Denk an die Buchstaben L, A, G, E und R. Je nach Reihenfolge wird daraus Lager oder Regal, zwei ganz verschiedene Wörter. Bei Proteinen bestimmt die Reihenfolge der Aminosäuren, wie sich die Kette faltet und was sie kann: Keratin fürs Haar oder Hämoglobin fürs Blut. Aber wer legt diese Reihenfolge fest?
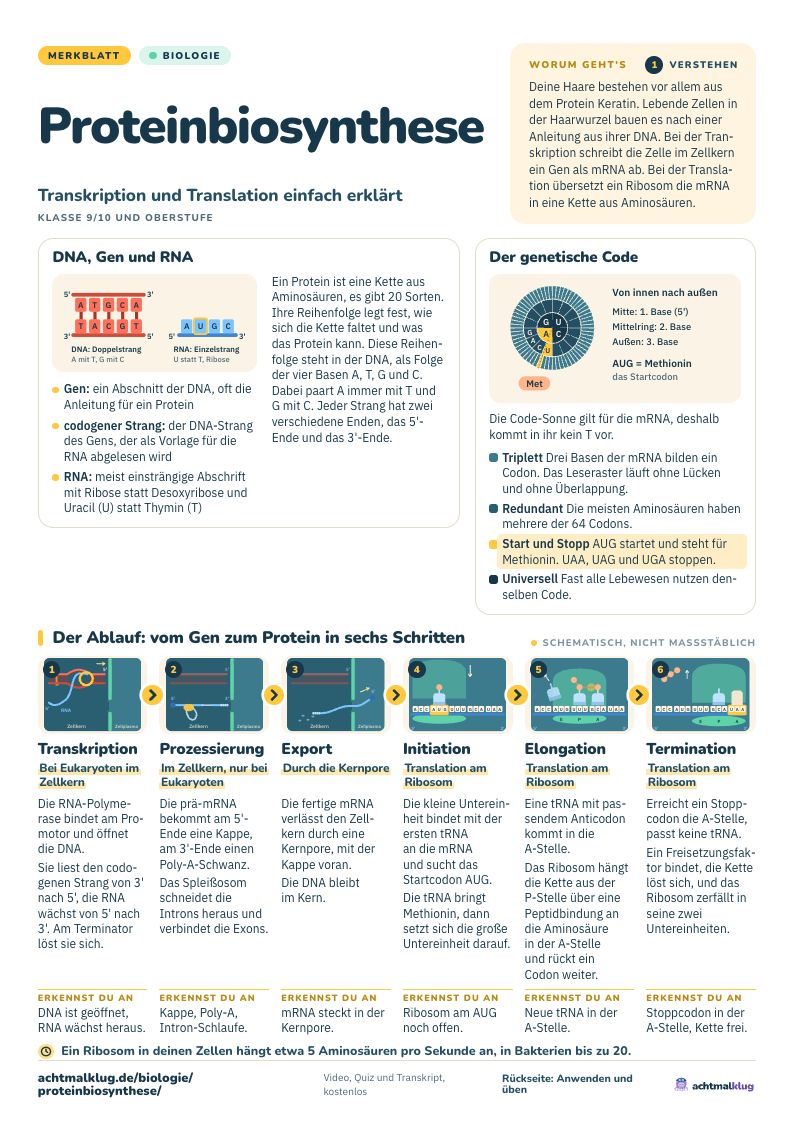
Die D-N-A im Zellkern. Stell sie dir vor wie eine lange, verdrehte Leiter. Jede Sprosse besteht aus zwei Basen, die zusammenpassen. Es gibt vier Basen, kurz A, T, G und C. Ausgeschrieben heißen sie Adenin, Thymin, Guanin und Cytosin, aber meist reichen die Buchstaben. Sie passen immer gleich: A mit T, G mit C. Diese Basen sind die Buchstaben der Anleitung.
Ein Gen ist ein Abschnitt dieser Leiter, oft die Anleitung für ein Protein. Die Reihenfolge seiner Basen legt fest, in welcher Reihenfolge die Aminosäuren aneinandergehängt werden. Funfact: Nur rund eineinhalb Prozent deiner D-N-A codieren tatsächlich Proteine. Wäre deine D-N-A ein Buch mit tausend Seiten, stünden die Proteine auf gerade mal fünfzehn.
Bleiben wir bei einem Gen, dem für Keratin. Damit gibt es ein Problem. Die D-N-A liegt im Zellkern. Proteine entstehen aber draußen im Zellplasma, an den Ribosomen. Warum nimmt die Zelle nicht einfach die D-N-A mit nach draußen? Weil sie das Original ist. Sie muss geschützt im Kern bleiben. Also schreibt die Zelle nur das ab, was sie gerade braucht: das eine Gen.
Die Abschrift ist keine D-N-A, sondern R-N-A. Sie ist der D-N-A ähnlich, mit drei Unterschieden. Erstens: Ihr Zucker heißt Ribose statt Desoxyribose. Desoxy heißt: Dem Zucker der D-N-A fehlt ein Sauerstoffatom. Zweitens: Statt Thymin trägt sie Uracil, also U statt T. Uracil paart wie Thymin mit A. Drittens: Sie ist meist einzelsträngig, sozusagen eine halbe Leiter. Kurz gesagt: R-N-A ist eine einsträngige Abschrift mit U statt T.
Wie entsteht so eine Abschrift? Durch Transkription, das heißt einfach Abschreiben. Das übernimmt ein Enzym, sozusagen der Stift der Zelle: die R-N-A-Polymerase. Aber woher weiß sie, wo ein Gen anfängt? Vor jedem Gen liegt eine Startstelle, der Promotor. Dort bindet die Polymerase und öffnet die Leiter ein Stück weit, wie einen Reißverschluss. Jetzt liegen die Basen frei.
Und welcher der beiden Stränge wird abgelesen? Nur einer, der codogene Strang. Er ist die Vorlage, an der die R-N-A entsteht. Der andere Strang wird dabei nicht abgelesen. Und abgeschrieben wird nicht die ganze D-N-A, sondern nur dieses eine Gen.
Bleibt die Frage, an der in Klausuren viele hängen: In welche Richtung wird gelesen? Jeder Strang hat zwei verschiedene Enden, wie ein Zug mit Lok und letztem Wagen. Sie heißen fünf-Strich-Ende und drei-Strich-Ende. Die Polymerase kann neue Bausteine ausschließlich am drei-Strich-Ende der wachsenden R-N-A anhängen, so wie man Wagen nur hinten ankoppelt. Deshalb wächst die R-N-A immer von fünf-Strich nach drei-Strich.
Und die Vorlage? Die neue R-N-A und der codogene Strang liegen gegenläufig aneinander, wie die zwei Spuren einer Straße: nebeneinander, aber in entgegengesetzter Richtung. Das heißt antiparallel. Deshalb liest die Polymerase den codogenen Strang von drei-Strich nach fünf-Strich. Also: Vorlage drei-Strich nach fünf-Strich, Abschrift fünf-Strich nach drei-Strich. Immer gegenläufig.
Probieren wir es an einem Beispiel, ganz langsam. Auf dem codogenen Strang steht, von drei-Strich nach fünf-Strich: T, A, C. Gegenüber von T baut die Polymerase ein A ein. Gegenüber von A ein U, denn R-N-A hat kein T. Gegenüber von C ein G. Unser Ausschnitt der Abschrift beginnt also mit A, U, G. Wie bei Puzzleteilen passt an jede Base nur ein Partner. Weiter geht es mit A, A, A, daraus wird U, U, U. Dann C, G, T, daraus wird G, C, A. Und zuletzt A, T, T, daraus wird U, A, A.
Unsere Abschrift steht, zwölf Basen lang, und sie beginnt mit A, U, G. Merk sie dir, wir brauchen sie gleich noch. Am Ende des Gens erreicht die Polymerase eine Stoppstelle, den Terminator. Sie löst sich, die neue R-N-A kommt frei. Sie heißt m-R-N-A, Boten-R-N-A, weil sie die Botschaft hinausbringt. Merksatz: Bei der Transkription schreibt die R-N-A-Polymerase ein Gen ab. Vorlage ist der codogene Strang, heraus kommt m-R-N-A.
Schneiden und verschicken (6:30)
Bei Bakterien ginge es jetzt direkt los. In deinen Zellen nicht, hier wird es Oberstufe. Genau genommen heißt diese erste Abschrift prä-m-R-N-A, also Vorläufer-m-R-N-A. Bevor sie den Kern verlassen darf, wird sie bearbeitet, das ist die Prozessierung. Warum der Aufwand? Draußen im Zellplasma warten Enzyme, die R-N-A abbauen. Ohne Schutz wäre die Abschrift schnell zerlegt.
Also bekommt sie zwei Schutzteile. Am fünf-Strich-Ende eine Kappe. Am drei-Strich-Ende einen langen Schwanz aus vielen Adenin-Bausteinen, den Poly-A-Schwanz. Beide schützen vor dem Abbau und helfen beim Export aus dem Kern. Die Kappe hilft außerdem später dem Ribosom, den Anfang zu finden. Mütze auf, Schal um. Fast fertig für draußen.
Fast, denn vorher wird noch geschnitten. Stell dir einen Film vor, in dem zwischen den echten Szenen lange Stücke stecken, die nicht in den fertigen Film gehören. So sind die meisten deiner Gene gebaut. Die Abschnitte, die in der fertigen m-R-N-A bleiben, heißen Exons. Die Stücke dazwischen heißen Introns. Bei vielen menschlichen Genen sind die Introns zusammen viel länger als die Exons.
Nehmen wir eine prä-m-R-N-A mit drei Exons und zwei Introns. Ein großer Komplex, das Spleißosom, legt das erste Intron zu einer Schlaufe und schneidet es heraus. Dann verbindet er Exon eins mit Exon zwei. Mit dem zweiten Intron genauso. Übrig bleibt Exon eins, zwei, drei, lückenlos aneinander. Das ist das Spleißen. Die Exons bleiben in der m-R-N-A und verlassen mit ihr den Kern. Die Introns werden herausgeschnitten und im Kern abgebaut.
Und wird immer gleich geschnitten? Nein. Die Zelle kann beim Spleißen auch ein Exon weglassen. Aus eins, zwei, drei wird dann zum Beispiel nur eins und drei. Wie beim Film: Aus demselben Material lassen sich zwei Fassungen schneiden. Das ist alternatives Spleißen, daraus entsteht ein anderes Protein. Ein echtes Beispiel: Aus demselben Gen entsteht in der Schilddrüse das Hormon Calcitonin, in Nervenzellen dagegen ein ganz anderes Signalmolekül. Ein Gen, ein Protein stimmt also nicht immer.
Erst jetzt ist die m-R-N-A fertig. Sie verlässt den Zellkern durch eine Kernpore. Und die D-N-A? Viele denken, sie wandert selbst zum Ribosom. Tut sie nicht. Sie bleibt im Kern, hinaus geht nur die Abschrift. Lebewesen mit Zellkern wie du heißen übrigens Eukaryoten. Merksatz: Bei Eukaryoten läuft die Transkription im Zellkern. Dort wird die prä-m-R-N-A erst bearbeitet und gespleißt, dann geht sie hinaus.
Vom Code zum Protein (9:18)
Die m-R-N-A ist draußen, mit einer Botschaft aus nur vier Buchstaben: A, U, G und C. Aminosäuren gibt es aber zwanzig. Wie passt das zusammen? Rechnen wir. Ein Buchstabe pro Aminosäure ergäbe nur vier Möglichkeiten. Zwei Buchstaben ergeben vier mal vier, also sechzehn. Immer noch zu wenig. Erst drei Buchstaben reichen: vier mal vier mal vier, also vierundsechzig. Deshalb liest die Zelle immer drei Basen auf einmal. So ein Dreierpack heißt Basentriplett, auf der m-R-N-A heißt es Codon.
Gelesen wird Codon für Codon, ohne Lücken und ohne Überlappung. Das ist wie ein Satz aus lauter Wörtern mit drei Buchstaben: Die Kuh sah den Hut. Fängst du einen Buchstaben zu spät an, liest du nur noch Unsinn. Deshalb ist der richtige Startpunkt so wichtig. Diese Einteilung in Dreiergruppen heißt Leseraster.
Vierundsechzig Codons für zwanzig Aminosäuren. Wohin mit dem Überschuss? Die meisten Aminosäuren haben einfach mehrere Codons. Der Code ist redundant, man sagt auch degeneriert. Und vier Codons haben Sonderaufgaben. A, U, G ist das Startcodon, sozusagen der Großbuchstabe am Satzanfang. Hier beginnt die Übersetzung, und es steht für Methionin. U, A, A, U, A, G und U, G, A sind Stoppcodons. Sie stehen für keine Aminosäure, sondern für das Ende, wie der Punkt am Satzende.
Und fast alle Lebewesen benutzen denselben Code, vom Bakterium bis zu dir. Der Code ist universell. Das hat praktische Folgen: Baut man Bakterien die menschliche Bauanleitung für Insulin ein, und zwar schon ohne Introns, denn Bakterien spleißen nicht, stellen sie menschliches Insulin her, für Menschen mit Diabetes. Kurz gesagt: Der Code ist redundant und universell.
Welches Codon wofür steht, zeigt die Code-Sonne. Sie sieht kompliziert aus, aber es gibt nur zwei Regeln. Erstens: Sie gilt für die m-R-N-A, nicht für die D-N-A. Deshalb kommt in ihr kein T vor. Zweitens: Du liest von innen nach außen. Die erste Base des Codons, vom fünf-Strich-Ende her, steht in der Mitte. Die zweite steht im mittleren Ring, die dritte außen.
Übersetzen wir unsere Abschrift von vorhin. Erstes Codon: A, U, G. Innen A, im mittleren Ring U, außen G. Methionin, der Start. Zweites Codon: U, U, U. Innen U, Mitte U, außen U. Das ist Phenylalanin. Drittes Codon: G, C, A. Innen G, Mitte C, außen A. Alanin. Und U, A, A? Stopp. Aus zwölf Basen werden drei Aminosäuren: Methionin, Phenylalanin, Alanin.
Und jetzt schau dir das Feld um G und C noch einmal an. Ob außen U, C, A oder G steht: Es bleibt Alanin. So sieht redundant aus. Merksatz: Drei Basen der m-R-N-A bilden ein Codon. Die Code-Sonne liest du von innen nach außen. Jetzt kennst du die Sprache. Aber wer übersetzt?
Drei Buchstaben, eine Aminosäure (12:40)
Zwei Mitspieler. Das Ribosom ist die Lesemaschine, gebaut aus einer kleinen und einer großen Untereinheit. Dazu kommen Übersetzer zwischen zwei Sprachen: Basen auf der einen Seite, Aminosäuren auf der anderen. Stell dir einen Reiseadapter vor, mit zwei verschiedenen Enden. Genau das ist eine t-R-N-A.
Eine t-R-N-A ist selbst ein kleines, gefaltetes R-N-A-Molekül. An einem Ende hängt eine Aminosäure. Am anderen sitzen drei Basen, das Anticodon. Es paart mit einem Codon der m-R-N-A, wie die Basen in der D-N-A. Ein Beispiel: Zum Codon U, U, U passt das Anticodon A, A, A. Und genau diese t-R-N-A trägt Phenylalanin. Wichtig fürs Abitur: Das Anticodon liegt gegenläufig zum Codon. Wir schreiben es hier so, wie es dem Codon gegenübersteht, also von drei-Strich nach fünf-Strich.
Und genau hier passiert ein häufiger Fehler in Klassenarbeiten: Die t-R-N-A bringe die Basen zum Ribosom. Nein. Die Basen stehen schon auf der m-R-N-A. Die t-R-N-A bringt die Aminosäure. Ihr Anticodon ist wie ein Schlüssel: Nur am passenden Codon hält sie fest.
Jetzt schauen wir dem Ribosom bei unserem Beispiel zu. Den Anfang macht die Initiation. Die kleine Untereinheit bindet mit der ersten t-R-N-A an die m-R-N-A und sucht das Startcodon A, U, G. Dort paart sich das Anticodon U, A, C mit dem Codon, und die t-R-N-A bringt Methionin. Dann setzt sich die große Untereinheit darauf. Das Ribosom ist komplett.
Innen hat das Ribosom drei Plätze für t-R-N-A-Moleküle. In der A-Stelle kommen neue an. In der P-Stelle hängt die wachsende Kette. Aus der E-Stelle gehen die leeren wieder. Merkhilfe: A wie Ankunft, P wie Peptid, also Aminosäurekette, E wie Exit. Die Fachnamen sind Aminoacyl-Stelle, Peptidyl-Stelle und Exit-Stelle. Die Start-t-R-N-A sitzt in der P-Stelle, die A-Stelle daneben ist noch frei.
Jetzt beginnt die Elongation, die Verlängerung, mit unserem Beispiel. In der A-Stelle liegt das Codon U, U, U. Die t-R-N-A mit dem Anticodon A, A, A rastet ein und bringt Phenylalanin. Das Ribosom hängt das Methionin aus der P-Stelle an das Phenylalanin, über eine Peptidbindung. Dann rückt das Ribosom genau ein Codon weiter, Richtung drei-Strich. Die t-R-N-A mit der Kette landet in der P-Stelle, die leere in der E-Stelle, und von dort geht sie.
Und dasselbe gleich noch einmal. In der A-Stelle liegt jetzt G, C, A. Die passende t-R-N-A mit dem Anticodon C, G, U bringt Alanin. Peptidbindung, ein Codon weiter, die leere t-R-N-A geht. Drei Buchstaben, eine Aminosäure. Immer weiter, bis zum Stopp.
Hör mal. Einrasten, verbinden, weiter. Einrasten, verbinden, weiter. Das Ribosom hat Rhythmus.
Eins!
Zwei!
Drei!
Ehrlich gesagt ist das Zeitlupe. Deine Ribosomen schaffen etwa fünf Aminosäuren pro Sekunde, Bakterien bis zu zwanzig. Fünf pro Sekunde, das sind dreihundert Beats pro Minute. Da kommen selbst acht Arme nicht mit. Und wann ist Schluss?
Sobald ein Stoppcodon in die A-Stelle rückt. In unserem Beispiel ist es U, A, A. Dazu passt keine t-R-N-A. Stattdessen bindet ein Protein, ein Freisetzungsfaktor. Die Kette löst sich ab, und das Ribosom zerfällt in seine zwei Untereinheiten. Das ist die Termination. Unser Beispiel ergibt die Kette Methionin, Phenylalanin, Alanin. Ein echtes Protein ist meist Hunderte Aminosäuren lang.
Frei geworden, faltet sich die Kette zu ihrer räumlichen Form. Erst diese Form macht ein Protein funktionsfähig. Beim Keratin winden sich mehrere Ketten umeinander zu zähen Fasern. Die Zellen der Haarwurzel füllen sich damit, verhornen und werden zu deinem Haar. Aus einer Zeile D-N-A ist ein Stück Haar geworden.
Merksatz: Bei der Translation übersetzt das Ribosom die m-R-N-A Codon für Codon in eine Aminosäurekette. Die t-R-N-A bringt die Aminosäuren, ihr Anticodon paart mit dem Codon. Polymerase, Spleißosom, Ribosom, t-R-N-A. Ganz schön viel Personal für ein Haar.
Wie eine Küche mit Archiv (17:32)
Personal, Rezepte, Zutaten. Eigentlich ist das eine Küche. Im Keller des Restaurants liegt ein Archiv, der Zellkern, darin ein dickes Kochbuch, die D-N-A, das nie hinaus darf. Wird ein Gericht bestellt, schreibt jemand genau ein Rezept ab, die m-R-N-A, und schickt die Abschrift nach oben.
Oben liest der Koch, das Ribosom, das Rezept immer drei Buchstaben auf einmal. Küchenhilfen, die t-R-N-A-Moleküle, bringen die Zutaten, die Aminosäuren. Jede trägt eine Nummer, ihr Anticodon, und nur wenn sie zum Rezept passt, nimmt der Koch die Zutat an. Zutat für Zutat entsteht das Gericht: das Protein.
Und wo hinkt der Vergleich? An drei Stellen. Erstens denkt in der Zelle niemand nach. Kein Koch weiß, was er kocht, keine Küchenhilfe sucht. Die Moleküle stoßen zufällig zusammen, und nur was passt, hält. Zweitens wird die Abschrift vorher zurechtgeschnitten: Introns raus. Und drittens lesen oft viele Ribosomen gleichzeitig dieselbe m-R-N-A. Das nennt man Polysom. Viele Köche verderben den Brei? Hier gibt's einfach mehr Brei.
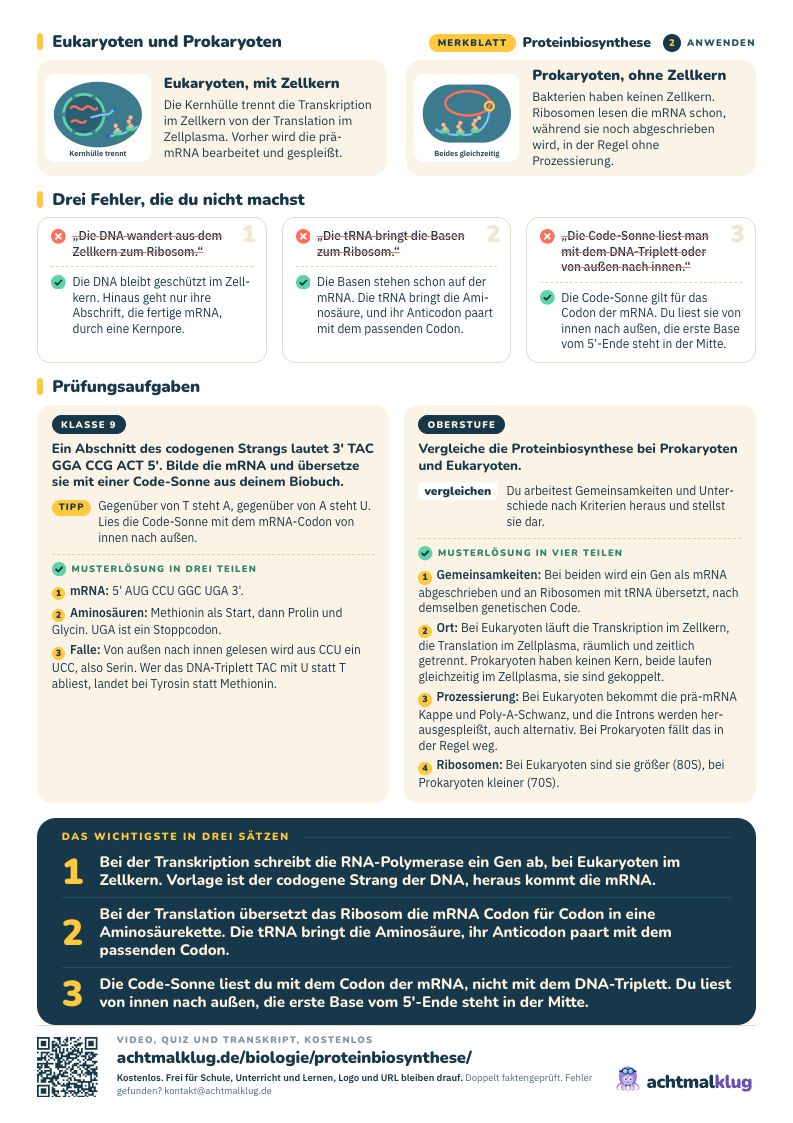
Bleibt noch die Bakterienküche. Wie kocht die? Prokaryoten wie Bakterien haben keinen Zellkern, also kein Archiv. Deshalb setzen sich Ribosomen schon an die m-R-N-A, während sie noch abgeschrieben wird. Transkription und Translation laufen gleichzeitig. Bearbeitet wird die m-R-N-A in der Regel nicht: keine Kappe, kein Spleißen. Ihre Ribosomen sind etwas kleiner, im Lehrbuch steht siebzig S statt achtzig S.
Merksatz: Bei Eukaryoten trennt die Kernhülle Transkription und Translation. Bei Prokaryoten laufen beide gleichzeitig im Zellplasma, in der Regel ohne Prozessierung.
Prüfung (19:28)
Genug gekocht, jetzt bist du dran. Aufgabe eins, Niveau Klasse neun: Gegeben ist ein Abschnitt des codogenen Strangs, von drei-Strich nach fünf-Strich: T, A, C, G, G, A, C, C, G, A, C, T. Bilde die m-R-N-A und übersetze sie mit der Code-Sonne. Drück Pause. Kleiner Tipp: Die Code-Sonne beißt nicht. Sie sieht nur so aus.
Die Lösung: T wird zu A, A zu U, G zu C, C zu G. Die m-R-N-A lautet von fünf-Strich nach drei-Strich, in Dreiergruppen: A, U, G, Methionin, der Start. C, C, U, Prolin. G, G, C, Glycin. Und U, G, A heißt Stopp. Die Falle: Wer von außen nach innen liest, macht aus C, C, U ein U, C, C, also Serin. Und wer das D-N-A-Triplett T, A, C mit U statt T abliest, landet bei Tyrosin statt Methionin.
Eine Stufe schwerer. Aufgabe zwei, Niveau Oberstufe: „Vergleichen Sie die Proteinbiosynthese bei Prokaryoten und Eukaryoten.“ Vergleichen heißt: Gemeinsamkeiten und Unterschiede nach Kriterien herausarbeiten und darstellen. Drück Pause und formuliere.
Für volle Punkte nennst du Gemeinsamkeiten und Unterschiede nach Kriterien. Erstens, die Gemeinsamkeiten: Bei beiden wird ein Gen in m-R-N-A umgeschrieben und an Ribosomen mit t-R-N-A übersetzt, nach demselben genetischen Code. Zweitens, Ort und Zeit: Bei Eukaryoten läuft die Transkription im Zellkern, die Translation im Zellplasma, beide sind räumlich und zeitlich getrennt. Prokaryoten haben keinen Kern, bei ihnen laufen beide gleichzeitig im Zellplasma, sie sind gekoppelt. Drittens, die Prozessierung: Bei Eukaryoten bekommt die prä-m-R-N-A Kappe und Poly-A-Schwanz, und die Introns werden herausgespleißt, auch alternativ. Bei Prokaryoten fällt das in der Regel weg. Viertens, die Ribosomen: Bei Eukaryoten sind sie größer, achtzig S, bei Prokaryoten kleiner, siebzig S.
Merk dir drei Dinge (21:51)
Das war die Proteinbiosynthese. Merk dir drei Dinge. Erstens: Bei der Transkription wird ein Gen in m-R-N-A umgeschrieben, Vorlage ist der codogene Strang. Zweitens: Bei der Translation bringt die t-R-N-A die Aminosäure, ihr Anticodon paart mit dem Codon. Drittens: Die Code-Sonne liest du mit dem m-R-N-A-Codon, von innen nach außen. Das Quiz und den Lernzettel zu diesem Video findest du kostenlos auf achtmalklug punkt de. Deine Haare sind während dieses Videos übrigens gewachsen, um rund fünf Tausendstel Millimeter. Meine nicht. Bleib neugierig.